Qué es el almacenamiento hiperconvergente y cómo organiza los datos
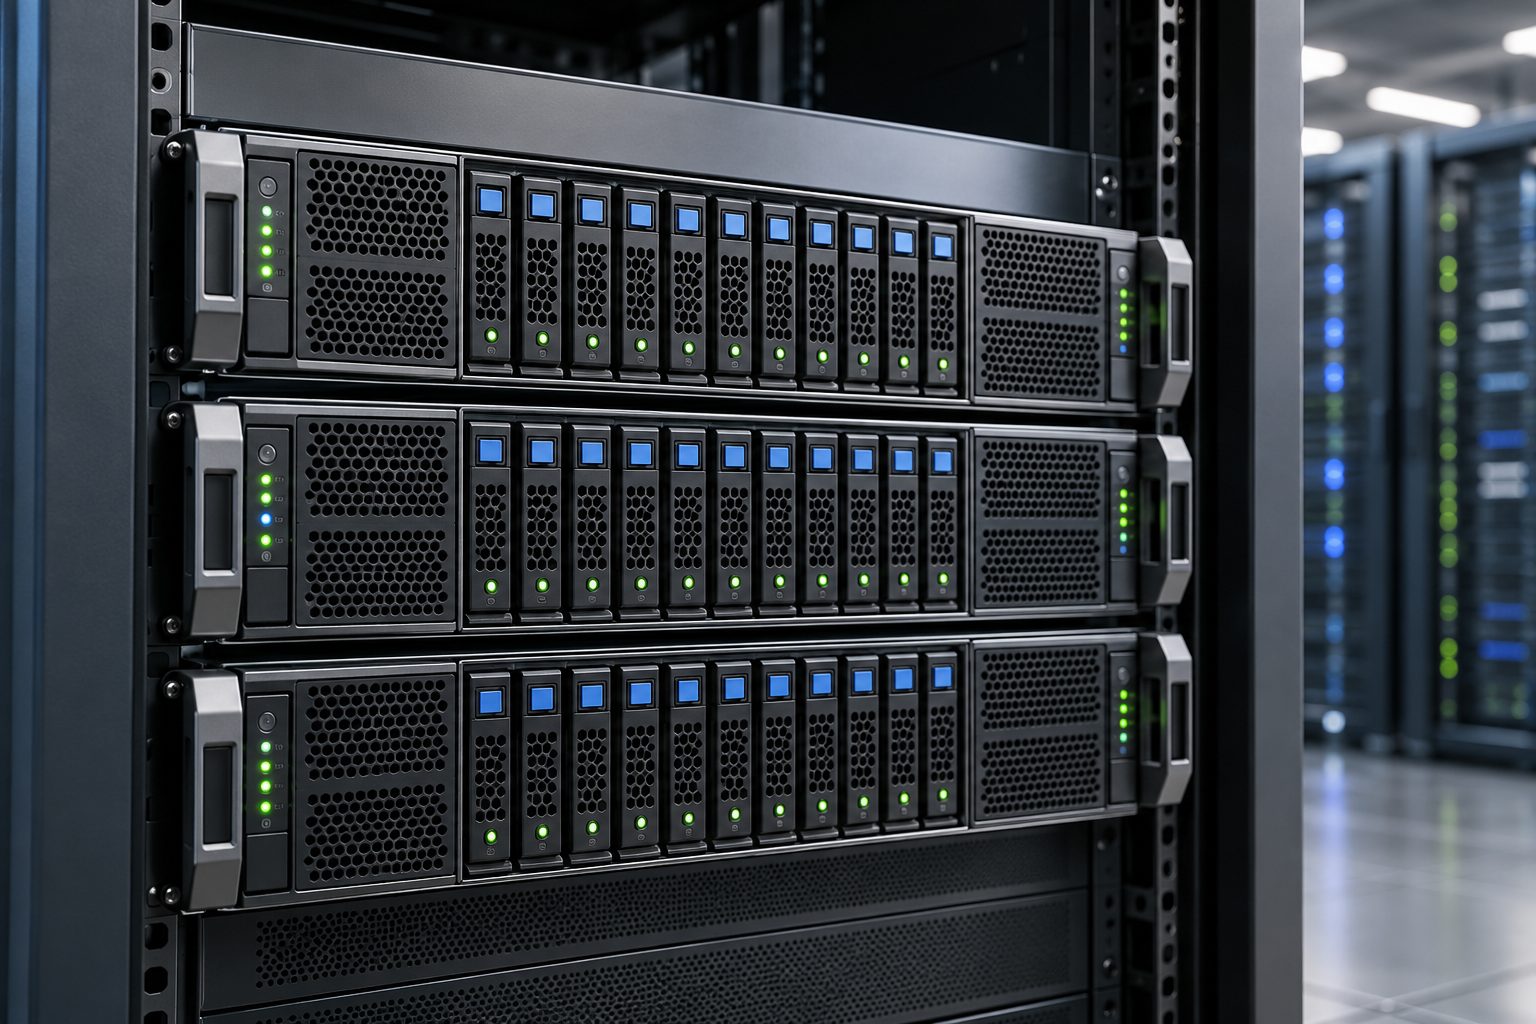
El almacenamiento hiperconvergente reúne los discos de varios servidores y los presenta como un recurso compartido gestionado por software. Esos servidores, llamados nodos, también pueden ejecutar las máquinas virtuales y aplicaciones. El resultado es una infraestructura en la que procesamiento y almacenamiento se administran de forma coordinada, en lugar de depender siempre de una cabina externa separada.
Para entenderlo podemos imaginar varios servidores que aportan sus unidades a un conjunto común. El software decide cómo distribuir los datos, protegerlos y atender las lecturas y escrituras. Lo que utiliza una máquina virtual es un recurso lógico, aunque sus datos estén repartidos físicamente entre distintos nodos.
Qué integra una infraestructura hiperconvergente
Una plataforma hiperconvergente combina recursos de cómputo, almacenamiento y virtualización, con funciones de red y gestión según el producto. Su diseño habitual utiliza servidores con discos locales y una capa de software que coordina el clúster. La integración concreta cambia entre fabricantes y configuraciones.
El hipervisor permite ejecutar máquinas virtuales sobre los servidores. La capa de almacenamiento agrega unidades y aplica las políticas definidas para los datos. Una consola puede facilitar tareas como asignar capacidad, revisar alertas o incorporar recursos, sin eliminar la necesidad de entender la arquitectura.
No todo almacenamiento definido por software es hiperconvergente. Podemos gestionar almacenamiento mediante software en sistemas que no comparten los nodos de cómputo. La hiperconvergencia describe una forma de integrar recursos y administrarlos, no simplemente el uso de una aplicación para controlar discos.
Cómo se escriben y se protegen los datos
Cuando una aplicación escribe información, la plataforma la coloca en el conjunto de almacenamiento de acuerdo con sus reglas. Puede mantener varias copias en nodos distintos o utilizar mecanismos de codificación que distribuyen datos y redundancia. Las opciones dependen del producto y de la política seleccionada.
El objetivo es que el fallo de un componente no implique necesariamente perder acceso a la información. Para lograrlo deben cumplirse condiciones sobre número de nodos, distribución de copias y capacidad disponible. No basta con activar una opción de protección sin comprobar esos requisitos.
Si se avería un disco o un nodo, el sistema puede reconstruir la protección utilizando recursos sanos. Durante esa operación aumenta el trabajo del clúster y puede cambiar el rendimiento. También existe un periodo en el que debemos gestionar el riesgo de nuevos fallos mientras se recupera la redundancia.
La tolerancia a fallos depende del diseño y de la política aplicada. No podemos atribuir al conjunto una resistencia ilimitada por contener varios servidores. La pérdida de un rack, de la red o de la sala completa puede afectar simultáneamente a recursos que parecían independientes.
Capacidad bruta y capacidad realmente utilizable
La suma de los discos ofrece una cifra de capacidad física, pero parte se dedica a redundancia, metadatos y funcionamiento interno. Además, conviene reservar espacio para mantenimiento, reconstrucciones y crecimiento. La capacidad que podremos asignar a las aplicaciones será menor que el total instalado.
Las funciones de compresión o deduplicación pueden reducir la ocupación en ciertos datos. Su resultado cambia según el contenido, por lo que no conviene basar todo el dimensionamiento en una proporción comercial. Los datos ya comprimidos o cifrados pueden comportarse de otra manera.
La previsión debe incluir el crecimiento de las aplicaciones y de las instantáneas. Una retención extensa puede consumir mucho espacio aunque los discos virtuales parezcan pequeños. También debemos considerar las reservas necesarias para mantener la protección cuando un nodo no esté disponible.
Qué papel tiene la red del clúster
Los nodos necesitan comunicarse para distribuir datos, mantener copias y coordinar operaciones. Esa circulación convierte la red en una parte central del almacenamiento. La velocidad de los enlaces, la latencia y la redundancia influyen en el comportamiento del conjunto.
Una infraestructura con discos rápidos puede rendir por debajo de lo esperado si su red introduce un cuello de botella. La configuración de switches y adaptadores debe seguir los requisitos de la plataforma, con atención a los recorridos que eviten un único punto de fallo.
Las pruebas deben incluir actividad simultánea y situaciones de mantenimiento. Medir solo una lectura aislada en un clúster vacío aporta poca información sobre el funcionamiento durante una copia, una reconstrucción o un pico de trabajo de varias máquinas virtuales.
En qué se diferencia de SAN, NAS y nube
En una arquitectura tradicional, los servidores pueden acceder a una cabina de almacenamiento mediante una red específica o compartir archivos desde un NAS. La hiperconvergencia habitual utiliza el almacenamiento local de los nodos como base de un recurso distribuido. Eso cambia cómo se amplía y mantiene la infraestructura.
SAN y NAS describen formas de proporcionar o acceder a almacenamiento, mientras que hiperconvergencia describe una arquitectura. Algunas plataformas pueden ofrecer servicios de archivos o bloques adicionales. Por eso no conviene comparar los términos como si todas sus funciones fueran excluyentes.
La nube tampoco es sinónimo de hiperconvergencia. Un clúster puede funcionar en las instalaciones de la empresa y ofrecer una gestión centralizada sin convertirse por ello en un servicio de nube pública. La integración con servicios externos depende de las capacidades y contratos elegidos.
Ventajas y límites al ampliar recursos
La incorporación de nodos compatibles puede ampliar capacidad y procesamiento, con una gestión más unificada. Sin embargo, los pasos de crecimiento dependen de las configuraciones admitidas. No siempre podemos añadir solo el recurso que falta con cualquier combinación de componentes.
Si una aplicación demanda mucho almacenamiento y poco procesamiento, debemos evaluar si el diseño obliga a comprar recursos de cómputo adicionales. También importan licencias, compatibilidad de hardware, soporte y posibilidades de evolución. Una plataforma sencilla de operar puede mantener dependencias relevantes del proveedor.
- Medir necesidades de capacidad, rendimiento y latencia de cada aplicación.
- Verificar requisitos de red, nodos y distribución de protección.
- Calcular capacidad útil con reservas para fallos y mantenimiento.
- Comparar el coste de ampliaciones y renovaciones de soporte.
Disponibilidad y copias de seguridad cumplen funciones distintas
Las réplicas ayudan a mantener servicio ante determinados fallos, pero pueden reproducir un borrado o una alteración de datos. Las instantáneas permiten volver a estados anteriores en ciertas condiciones, aunque su protección depende de dónde se almacenan y de quién puede modificarlas.
Necesitamos una estrategia de copia y recuperación separada del simple funcionamiento del clúster. La decisión de adoptar almacenamiento hiperconvergente debe incluir pruebas de restauración y fallos previstos, además del rendimiento normal. Así podremos valorar si la integración facilita la operación sin dejar fuera los requisitos que garantizan la recuperación de la actividad.


